Mac Studio のローカル LLM(oMLX)に、MacBook の OpenCode から長い作業をさせ、context、output、RoPE、YaRN、prompt cache の意味と挙動を確認しました。 Claude や Codex などサブスクリプションを使っていると考えなかったことでも、ローカルLLMで動かしてみると疑問や気付きがあるのが面白いところ。以下は不明点をAIに聞きながら、実測データを情報整理したものです。
環境と確認したかったこと
- マシン:Mac Studio(M5 Ultra、メモリ 256GB)
- サーバー:oMLX 0.7.3(MLX で LLM を動かす OSS のサーバー)
- モデル:Qwen3.8-27B の量子化版(重みの桁数を減らした版。約 17.5GB)
- クライアント:MacBook の OpenCode(コーディング agent)。自宅 LAN 経由で接続
用途は、長い会議の文字起こしを議事録にまとめることです。以前の設定(context 65,536)では、要約を頼んだ直後に compaction(古い履歴を要約に置き換える自動圧縮)が起き、原文の情報が失われました。context を 400,000 に変更したうえで、次の 3 点を確認しました。
- 400,000 と設定すれば、40 万 token を使えるのか
- モデルの標準の上限 262,144 は、設定値なのか、超えられない壁なのか
- prompt cache は何を節約するのか
token は LLM が文を数える単位です。このモデルの tokenizer でリポジトリ内の会議記録 5 件を数えたところ、日本語は平均で 1 token あたり約 1.9 文字でした。
1. 仕組みの確認
上限は 3 か所にある
oMLX の設定に max_context_window = 32768 があり、私はこれを上限だと読みました。ところが OpenCode は 111,830 token(28%)を表示しており(この時点の context は 400,000)、oMLX のログにも 99,799 token の入力が受理された記録がありました。32768 は上限として働いていません。
oMLX のコードを読むと、上限は次の優先順位で決まっていました。
- モデルごとの上書き設定(今回は未設定)
- モデル自身が持つ値(
config.jsonのmax_position_embeddings。今回は 262,144) - 全体の既定値(32768)。1 と 2 に値がないときだけ使う
32768 は予備の値で、このモデルでは使われていません。
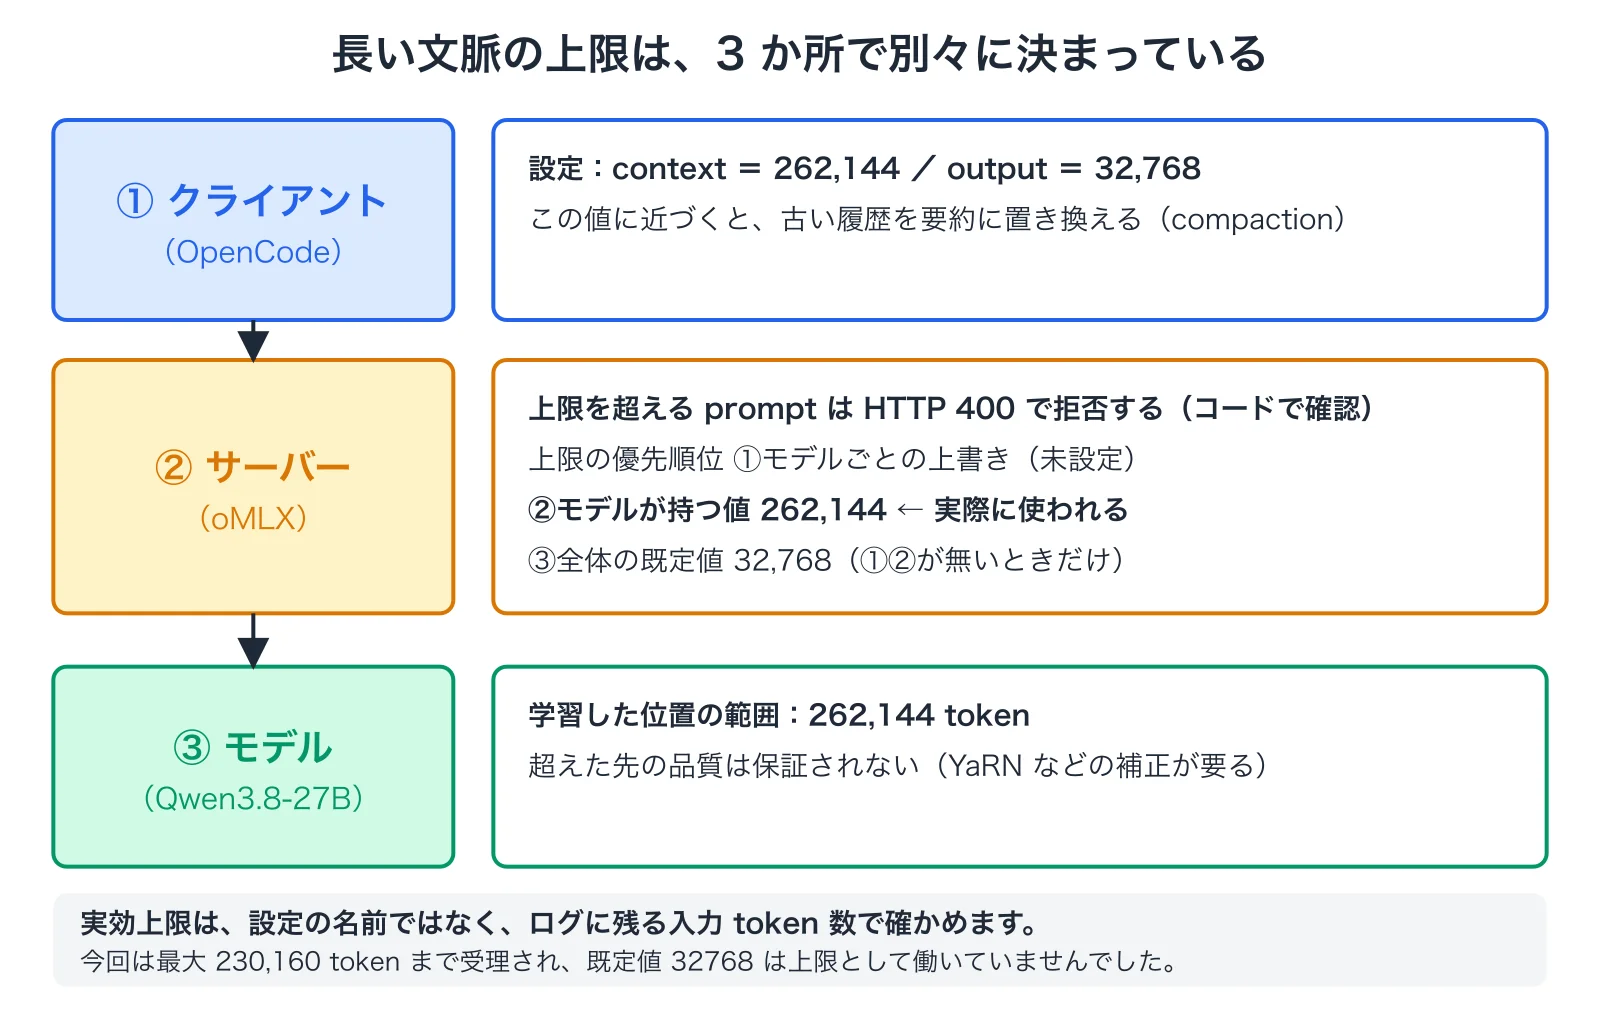
上限は次の 3 か所で別々に決まります。
- クライアント(OpenCode)の
context:この値に近づくと compaction する。 - サーバー(oMLX)の上限:超える入力は HTTP 400 で拒否する(コードからの読み取りで、実際の拒否は未確認)。
- モデルが学習した位置の範囲:262,144。
output は 1 回の応答で生成してよい最大の token 数で、OpenCode が oMLX に送る max_tokens にあたります。入力に使える量は context から output を引いた残りだと考えていますが、OpenCode の実装は読んでいないので推定です。
実効上限は、設定の名前ではなく、サーバーのログの入力 token 数で確かめます。oMLX のログには、request ごとに次の行が残ります。
Chat completion: model=..., 16384 tokens in 269.09s (62.9 tok/s), prompt: 143767, finish_reason=length, max_tokens=16384, ...prompt: が入力です。finish_reason=length は、max_tokens に達して打ち切られた印です。
262,144 は設定値なのか、超えられない壁なのか
どちらでもありません。262,144 はモデルが学習した位置の範囲です。サーバーの上限を上書きすれば、これを超える入力を受け付けることはできますが(優先順位の 1 で上書きできる、というコードからの読み取りです)、超えた先の品質は保証されません。oMLX は、この値を既定の拒否の上限にも使っていました(優先順位の 2)。
仕組みは RoPE(Rotary Position Embedding)です。query と key のベクトルを 2 次元ずつの組に分け、位置に比例した角度で回転させて位置を表します(RoFormer の論文)。組ごとに回転の速さが違い、速い針が近い距離、遅い針が遠い距離を区別します。回転後の内積は、位置の差だけに依存します。
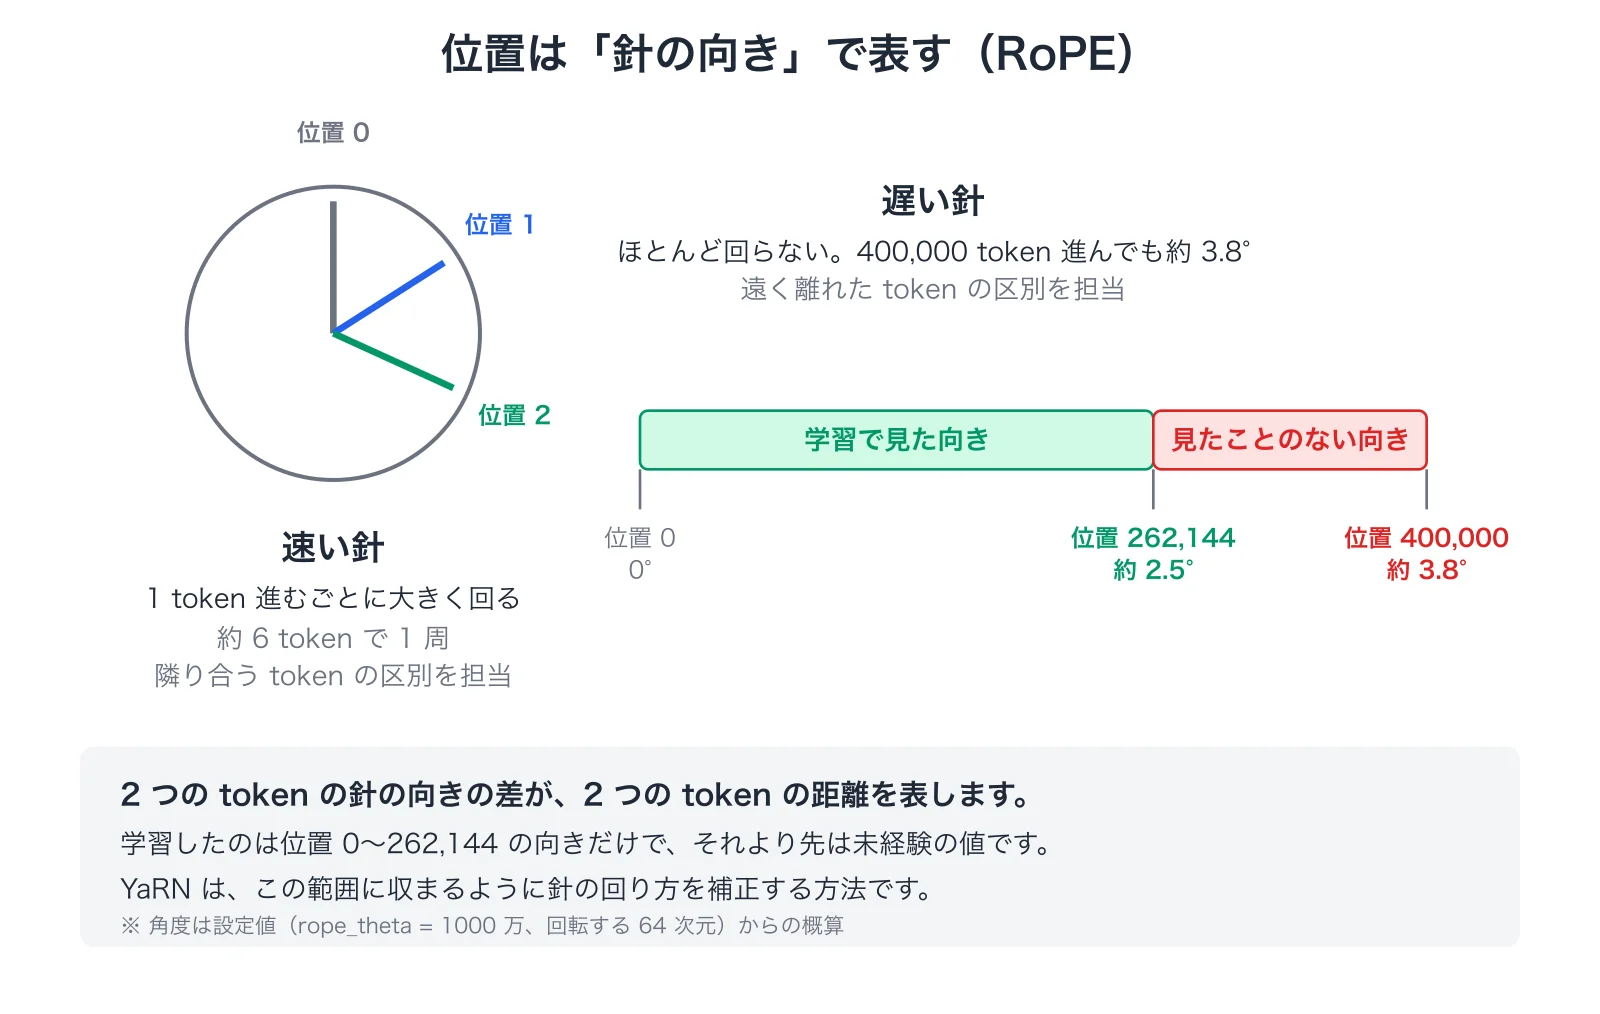
学習で見た針の向きは、位置 0〜262,144 の範囲だけです。設定値(rope_theta が 1000 万、回転する 64 次元)から概算すると、一番遅い針は位置 262,144 で約 2.5°、位置 400,000 で約 3.8° で、後者は学習で見たことのない向きです。この範囲の外では、遠い位置の参照の精度は保証されません(YaRN の論文は、RoPE で学習したモデルは学習時の長さを超えて汎化できないと述べています)。
27B は重みの数で、context の長さとは別です。RoPE は式で位置を表し、学習する数値を持ちません。context が長くなって増えるのは、実行時の KV cache のメモリです。重みは配布物なので、学習し直すこともできません。
YaRN は、使うときに範囲を広げる方法です(Peng らの論文)。速い針はそのままにして、遅い針だけを補間し、attention の強さも補正します。再学習なしの方式があり、微調整でも少量で足りると論文は述べています。一方、Qwen3 のモデルカードは、主要なフレームワークの YaRN は倍率が入力の長さによらず一定で、短い文の性能に影響しうるため、長い文脈が必要なときだけ設定するよう勧めています。今回のモデルの説明は未確認です。
400,000 は 262,144 の約 1.5 倍なので、40 万 token を使うには YaRN が要ります。今回は試していません。
prefill、decode、prompt cache
LLM は 1 回の request を 2 つの段階で処理します。
| 段階 | 何をするか | 時間の性質 |
|---|---|---|
prefill | 入力全体を読み、全 token の attention の中間結果(KV)を作る | 入力の長さに応じて増える。最初の token が出るまでの時間のほとんど |
decode | 答えを 1 token ずつ生成する | 出力の長さに応じて増える |
agent は、会話の続きを頼むたびに、履歴の全部と新しい発言を送り直します。サーバーが何も覚えていなければ、毎回、全文を prefill し直します。prompt cache(prefix cache)は、前回の request で作った KV を保存し、入力の先頭が同じ部分を再利用して、増えた末尾だけを読む仕組みです。vLLM の文書では、速くなるのは prefill で、decode は速くならないと説明されています。
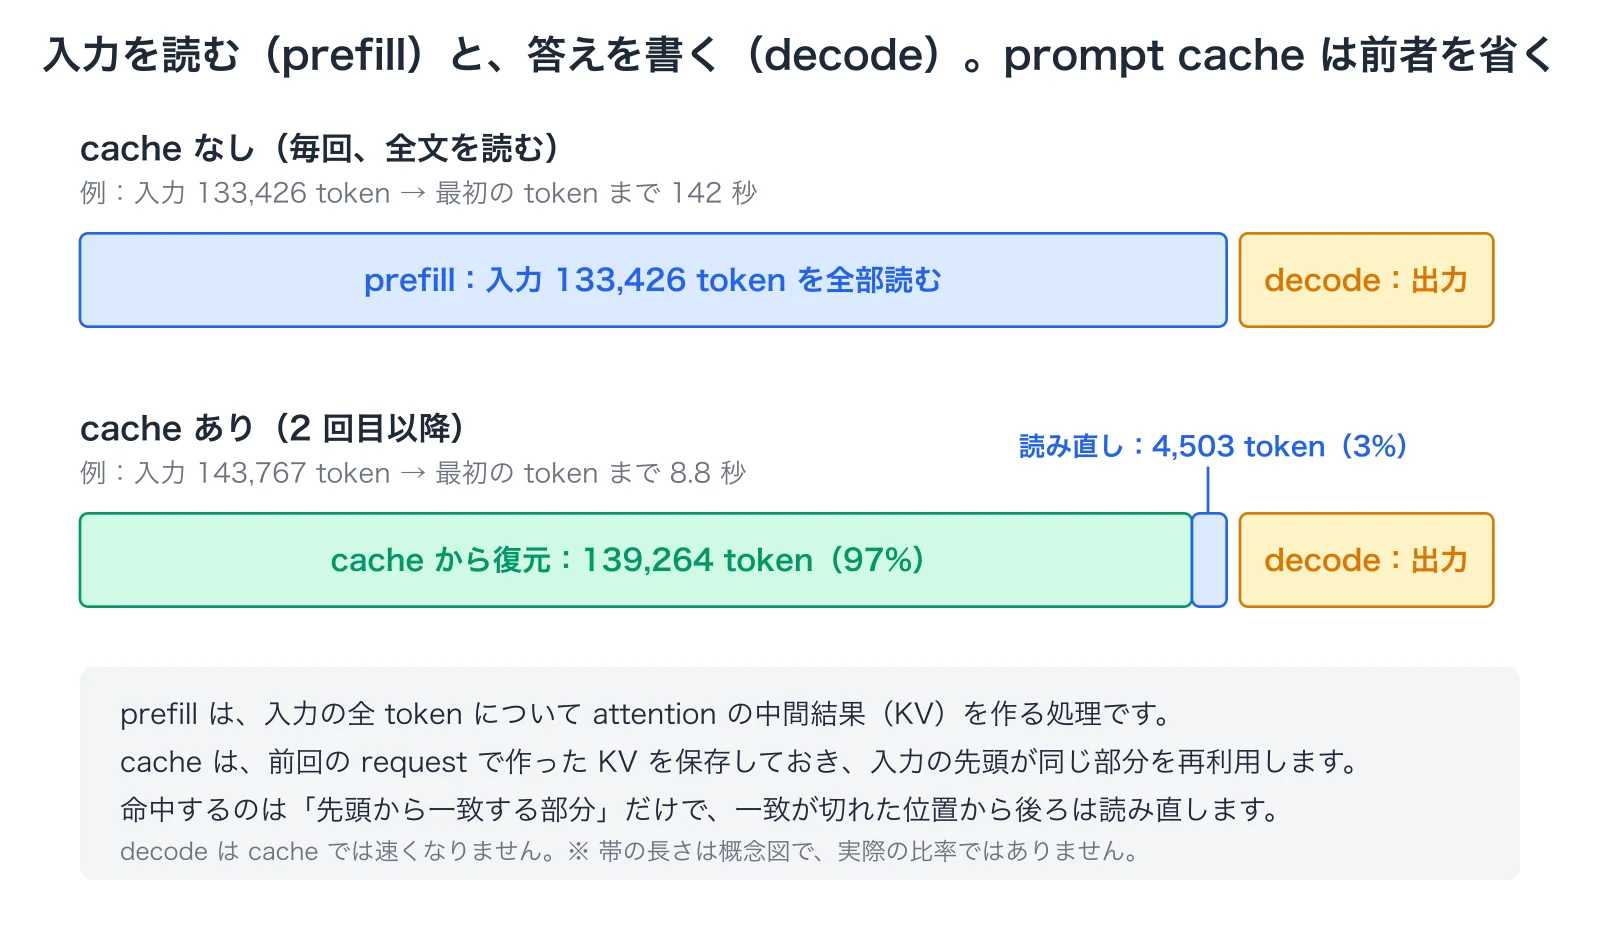
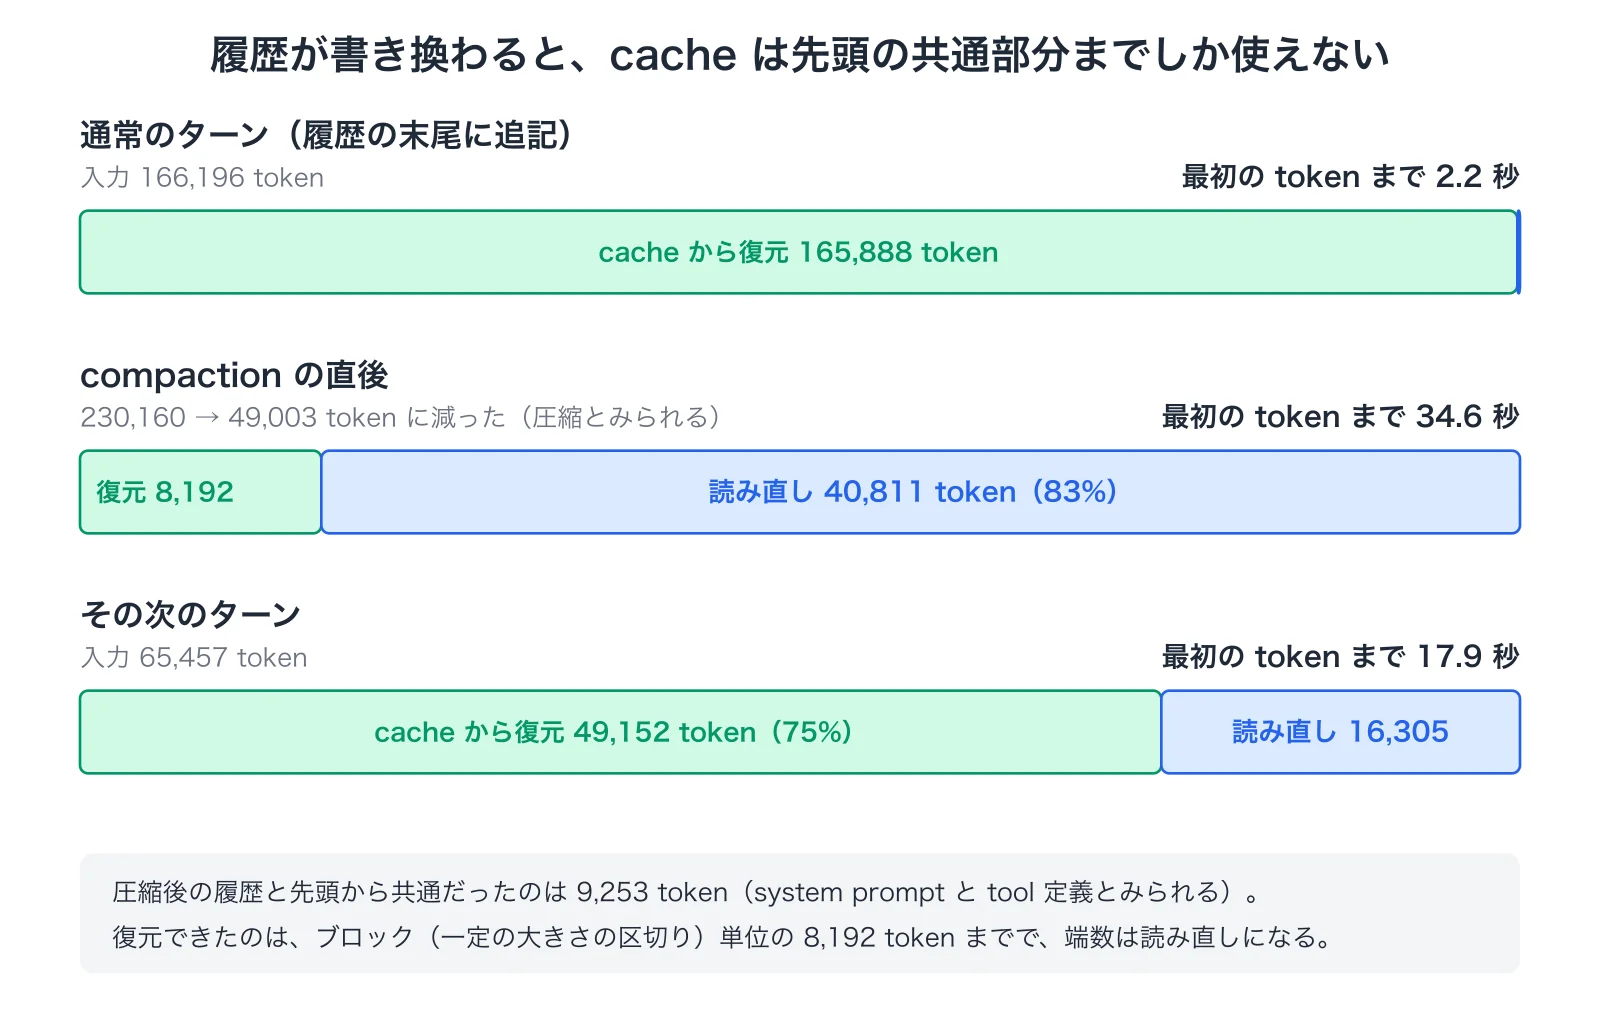
cache が使えるのは、入力の先頭から前回と一致する部分だけです。
cache が使えなくなる条件
当初、私は「余計な内容を会話に入れると、cache が汚れる」と考えていましたが、仕組みを確認すると少し違っていました。
- 履歴の末尾に追記するだけ:先頭は前回と同じなので、cache はそのまま使えます。雑談を足しても、増えた分を読むだけです。
- 履歴の途中が書き換わる:書き換わった位置から後ろは一致しないので、読み直しになります。compaction、system prompt や tool 定義の変更がこれにあたります。
実測でもこの違いが出ました(次の節)。
メモリは、このモデルでは 64 層のうち 16 層が KV cache の対象です(oMLX のログの数え方。config.json の層の種類は、4 層に 1 層が通常の attention、残りが linear attention でした)。1 token あたり約 64KB(oMLX のログの推定)で、262,144 token で約 17GB、400,000 token で約 26GB です。256GB に収まります。
2. 実測
OpenCode から長い作業を連続して実行し、oMLX のログから request ごとの数字を取りました。12:39〜16:16 の 161 request(以下「計測の範囲」)で、15:00 に cache を有効にして再起動しています。有効にしたのは起動 script の既定の変更だけで、もとは無効でした(理由は記録に残っていません)。前が 73 request(入力は最大 138,401 token)、後が 88 request(最大 230,160 token)です。
最初の token までの時間
| 入力の大きさ | cache なし(中央値) | cache あり(中央値) | 変化 |
|---|---|---|---|
5 万〜10 万 token | 52.6 秒(25 件) | 2.2 秒(12 件) | −96% |
10 万〜15 万 token | 144.8 秒(10 件) | 2.0 秒(27 件) | −99% |
15 万〜20 万 token | 未計測 | 3.0 秒(26 件) | — |
20 万〜25 万 token | 未計測 | 3.4 秒(20 件) | — |
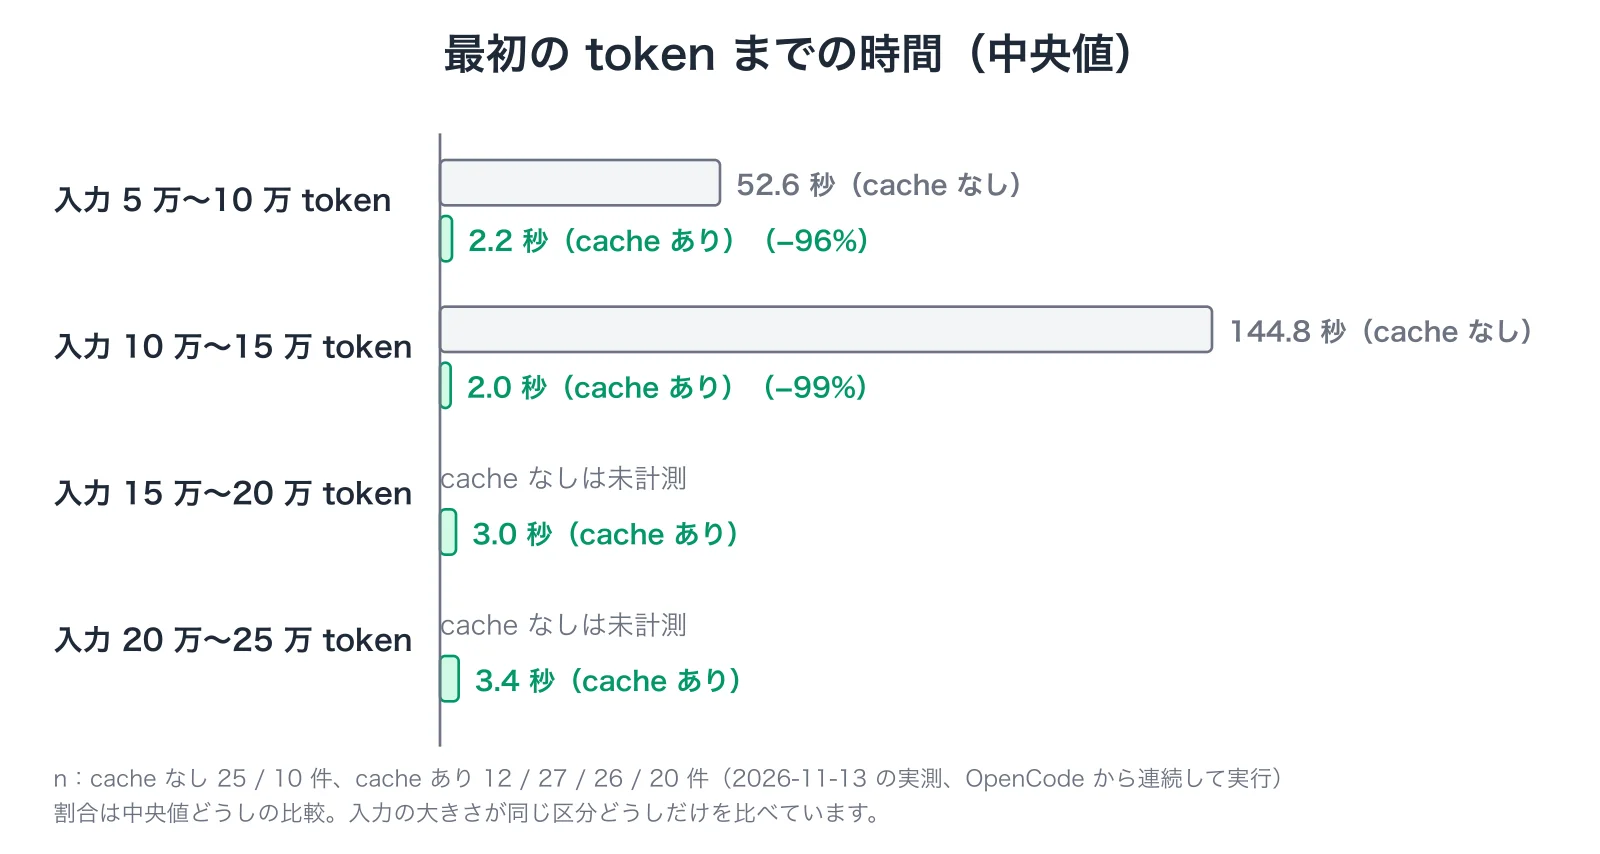
同じ大きさの入力では、cache なしで 133,426 token が 142 秒、138,401 token が 155 秒でした。cache ありでは、143,767 token のうち 139,264 token(97%)を復元し、読み直しは 4,503 token で、8.8 秒でした。166,196 token で読み直しが 308 token のときは 2.2 秒、160,198 token で読み直しが 12,742 token(8%)のときは 23.5 秒でした。時間は、入力の大きさよりも、読み直す量に左右されます。cache ありの 86 件は、中央値が 2.8 秒、最大が 34.6 秒でした。
compaction のあとの cache
15:36 に入力 230,160 token の request が終わり(出力 5,706 token)、直後の request が 49,003 token に減りました。OpenCode が会話を圧縮したとみています(OpenCode 側の記録は未確認)。
- 圧縮の直前(230,160 token):217,088 token(94%)を復元。読み直しは 13,072 token で、32 秒。
- 圧縮の直後(49,003 token):保存済みの履歴と共通だったのは、先頭の 9,253 token だけです。最初の request の入力が約 9,000 token だったことから、system prompt と tool 定義とみています。復元できたのは 8,192 token で、cache は一定の大きさの区切り(ブロック)単位で保存されるため、端数(1,061 token)は読み直しです。残りの 40,811 token(83%)を読み直し、34.6 秒でした。
- 次のターン(65,457 token):49,152 token(75%)を復元して 17.9 秒。その次(73,625 token)は 65,536 token(89%)を復元しました。復元量が前の入力 49,003 token より大きいのは、前の request の出力(16,384 token)も履歴に入り、その KV も保存されているためです。
出力の長さ
計測の範囲の 161 request で、出力の中央値は 519 token、95 パーセンタイル(95% の request がこの値以下)は 12,083 token でした。output が 16,384 前後の間に、上限に達して打ち切られた(finish_reason=length)request が 6 回ありました。32,768 に変更した後(計測の範囲より後の 16:55 の request)に、22,970 token の出力が自然に終わった例があります。出力は入力 20 万 token 付近で約 50 token/秒で、32,768 token なら最大で約 11 分かかります。
メモリとディスク
memory pressure(macOS のメモリ圧迫の指標)は最後まで通常の level 1 で、swap は 67MB のまま変わりませんでした(日の最初から同じ値)。cache の保存先は、作業後で約 73GB でした。
測定の限界
- 1 日・1 つの作業での測定で、cache 以外の条件(OpenCode の
contextの設定など)も同じ時間帯に変えています。最初の token までの時間は読み直した量にほぼ比例して縮み、ログにも cache の復元の行(Prefix cache restore)があるため、cache で説明できると考えています。再起動では cache 以外の内部の値も変わっている可能性があります(memory guard の上限が、再起動の前後で変わっていました)。 - 中央値は、同じ大きさの区分どうしで比べています。件数は区分で違います(表の括弧内)。
3. まとめ
- 長い入力では、待ち時間のほとんどが prefill です。cache なしでは入力が長いほど毎ターン待たされます。cache があると増えた分だけを読み、2〜3 秒で済む場合がありました。
- cache が使えるのは、入力の先頭から一致する部分だけです。末尾への追記では使い続けられ、compaction のように履歴の途中が書き換わると、その後ろは読み直しになります。
- 設定の数字は、名前から意味を決めず、ログで確かめます。
以下は私の考えです。Claude や Codex では、軽い質問や雑談まで同じ会話の中で続けてきました。当初は「余計な内容を入れると cache が汚れる」と考えていましたが、実測では、追記だけなら cache は残りました。それでも、余計な内容が増えるほど文脈が長くなり、compaction が早く来ます。compaction のたびに、先頭以外の履歴は読み直しになります(今回の例では 83%)。関係のない内容が混ざると回答の質にも影響するのではないかと感じていますが、これは測っていません。長い資料を読ませる会話と、軽い質問の会話は、分けるほうが効率がよいと考えています。Claude や Codex 側の cache の挙動は測っていません。
確認していないこと
- 262,144 を超える文脈(YaRN)の品質
- 長い文字起こしから作った議事録の品質(原文との照合)
- 打ち切られた応答の内容が、必要な長い出力だったか、繰り返しだったか
- Claude や Codex など、クラウドの cache の挙動